
В этой статье попробуем нейросеть Bonsai 2 27B - модель, которая показала, что даже 27B-модель может уместиться в 5.9 ГБ и работать на обычном ноутбуке (но запускать будем на мощном ПК, ведь он еще считается мощным, правда?). Разберемся, что это за модель, в чем ее преимущество и как запустить ее локально, если стандартные движки ее не видят.
Ternary Bonsai 2 27B - это модель, которая показала, что даже 27B-модель может уместиться в 5.9 ГБ и работать на обычном ноутбуке. По сути, это «сжатая» версия Qwen3.8 27B, которая сохраняет почти всю свою мощь, но занимает в 9 раз меньше места.
Что это за модель
Это результат работы компании PrismML, которая специализируется на экстремальном сжатии больших языковых моделей. В основе лежит архитектура Qwen3.8 27B от Alibaba, но с одним ключевым отличием: веса модели хранятся не в привычных 16 битах, а всего в трех значениях: -1, 0 и +1 (так называемые «тернарные» веса) - от этого и название ternary.
Для чего она нужна
Главная цель - дать возможность запускать модели 27B-класса локально, без мощных видеокарт и облачных серверов. Разработчики позиционируют ее для задач, где важна приватность и скорость: анализ документов, написание кода, работа с изображениями и даже сложные сценарии с вызовом инструментов.
В чем ее преимущество
Главный прорыв - это сохранение качества при радикальном уменьшении размера:
Экстремальное сжатие: Размер модели упал с ~54 ГБ (в полной точности) до 5.9 ГБ.
Почти без потерь: Она сохраняет 98.2% производительности полной версии Qwen3.8 27B. Для сравнения, первое поколение Bonsai (в июле 2026) сохраняло только 95%.
Скорость и энергоэффективность: На RTX 5090 она выдает до 143 токенов/с, а на RTX 4090 потребляет на 40% меньше энергии, чем обычная 8B-модель.
Ключевой нюанс для ПК
Как я уже выяснил на практике (чуть ниже), главный минус - привязка к собственному форку llama.cpp. Стандартные движки (вроде того, что в LM Studio) не умеют еен загружать из-за нестандартного формата весов и «повернутой» системы координат.
Мой типа «ноутбук» в лице домашнего ПК, его характеристики:
- CPU: Intel core i5 12600k - 10 ядер;
- RAM: 32 GB DDR4;
- GPU: RTX 3070 8 GB.
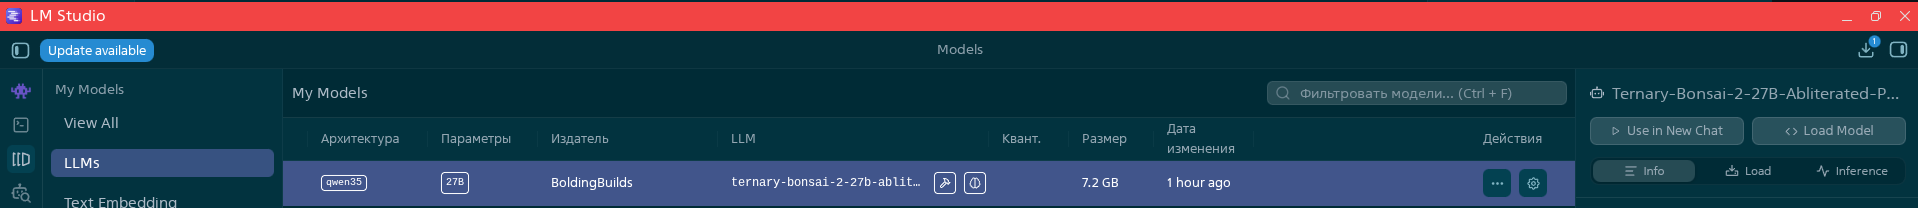
Загрузил я ее через LM Studio, но при загрузке модели я получаю ошибку.
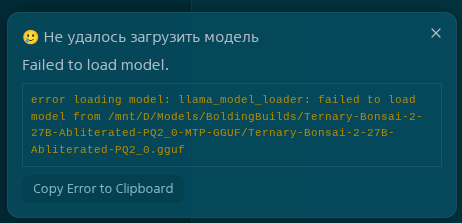
Пообщавшись с deepseek, выяснили, что для данной модели нужен специальный форк llama.cpp.
Нейронка посоветовала скачать форк движка и запустить через отдельный сервер llama.cpp.
Шаг 1. Готовим директорию для форка
Создаем директорию для форка движка:
mkdir ~/bonsai-engine
cd ~/bonsai-engine
Шаг 2. Скачиваем форк движка
Идем на официальный репозиторий на GitHub.
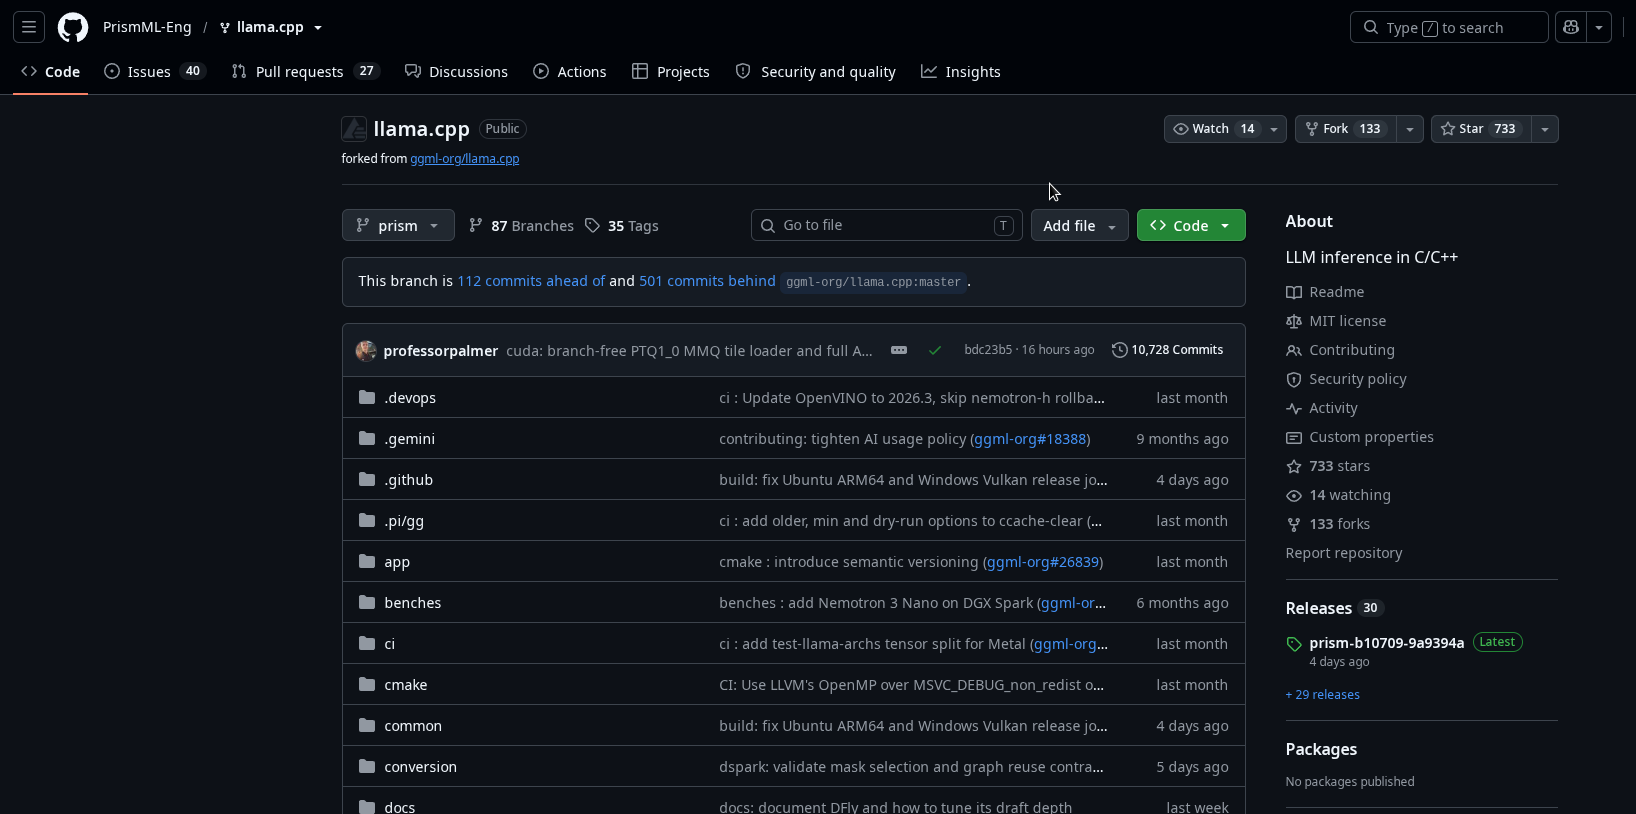
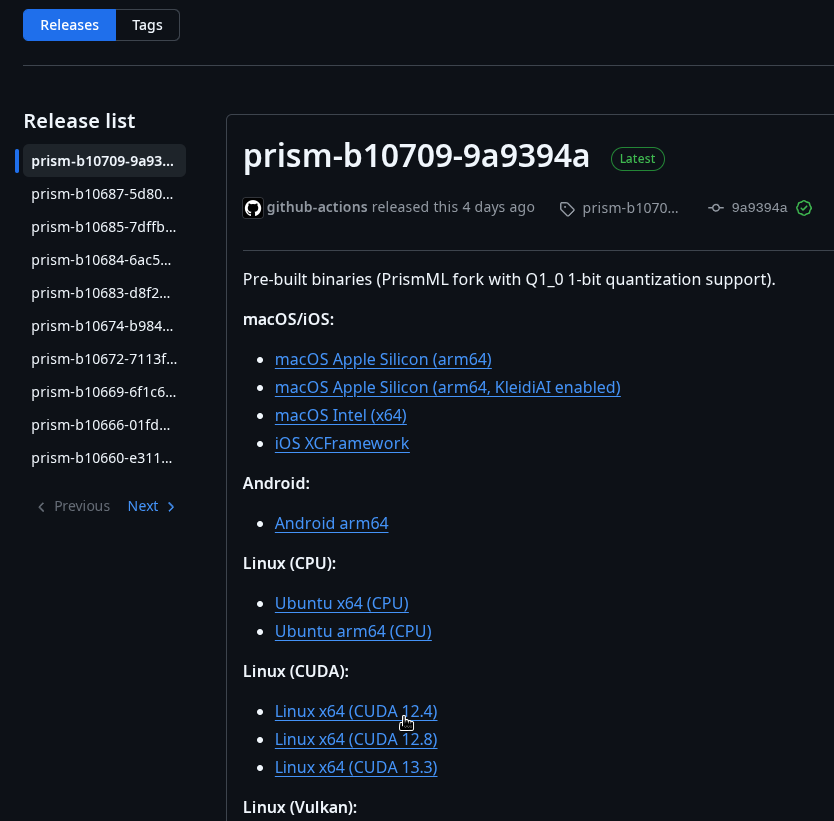
Справа находим релизы.
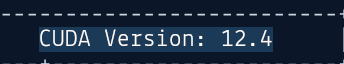
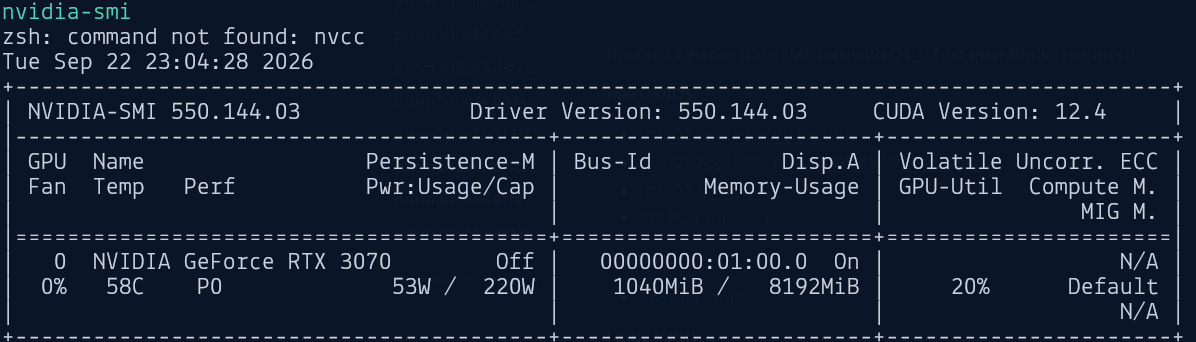
Выбираем последний релиз и находим Linux (CUDA). У меня версия 12.4, поэтому я загружаю эту. Как узнать версию - выполните nvidia-smi.
Там будет что-то типа: CUDA Version: 12.4
Шаг 3. Распаковываем и проверяем
После загрузки движка перенесем его в ~/bonsai-engine:
mv ~/Загрузки/llama-prism-b10709-9a9394a-bin-linux-cuda-12.4-x64.tar.gz .
Распакуем архив:
tar xzvf llama-prism-b10709-9a9394a-bin-linux-cuda-12.4-x64.tar.gz
Перейдем в извлеченный каталог:
cd llama-prism-b10709-9a9394a
Проверяем нашу видеокарту:
./llama-server --list-devices
Я получил ошибку:
./llama-server: error while loading shared libraries: libcudart.so.12: cannot open shared object file: No such file or directory
Шаг 4. Устанавливаем CUDA Toolkit
Для решения этой проблемы дипсик посоветовал установить CUDA Toolkit. Загрузим его с официального сайта.
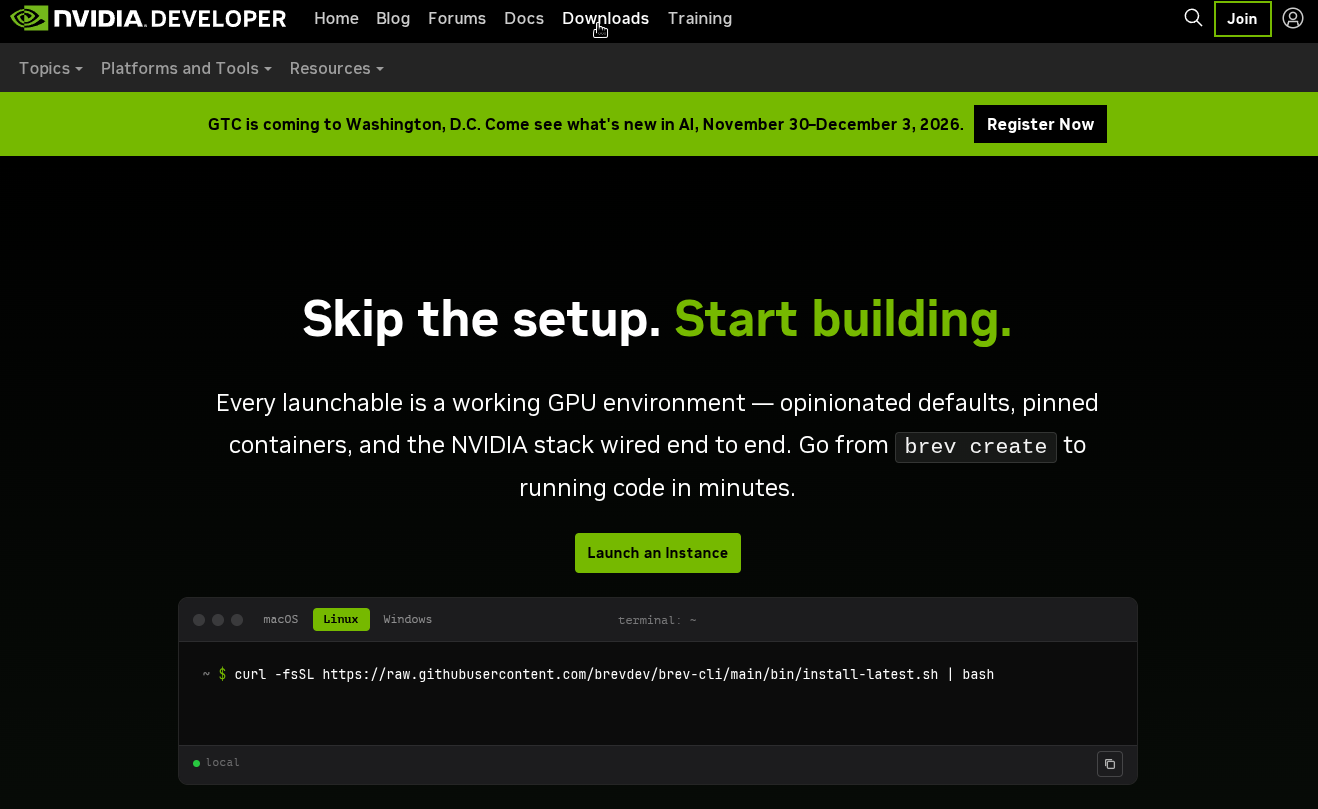
Сверху нажимаем на Downloads.
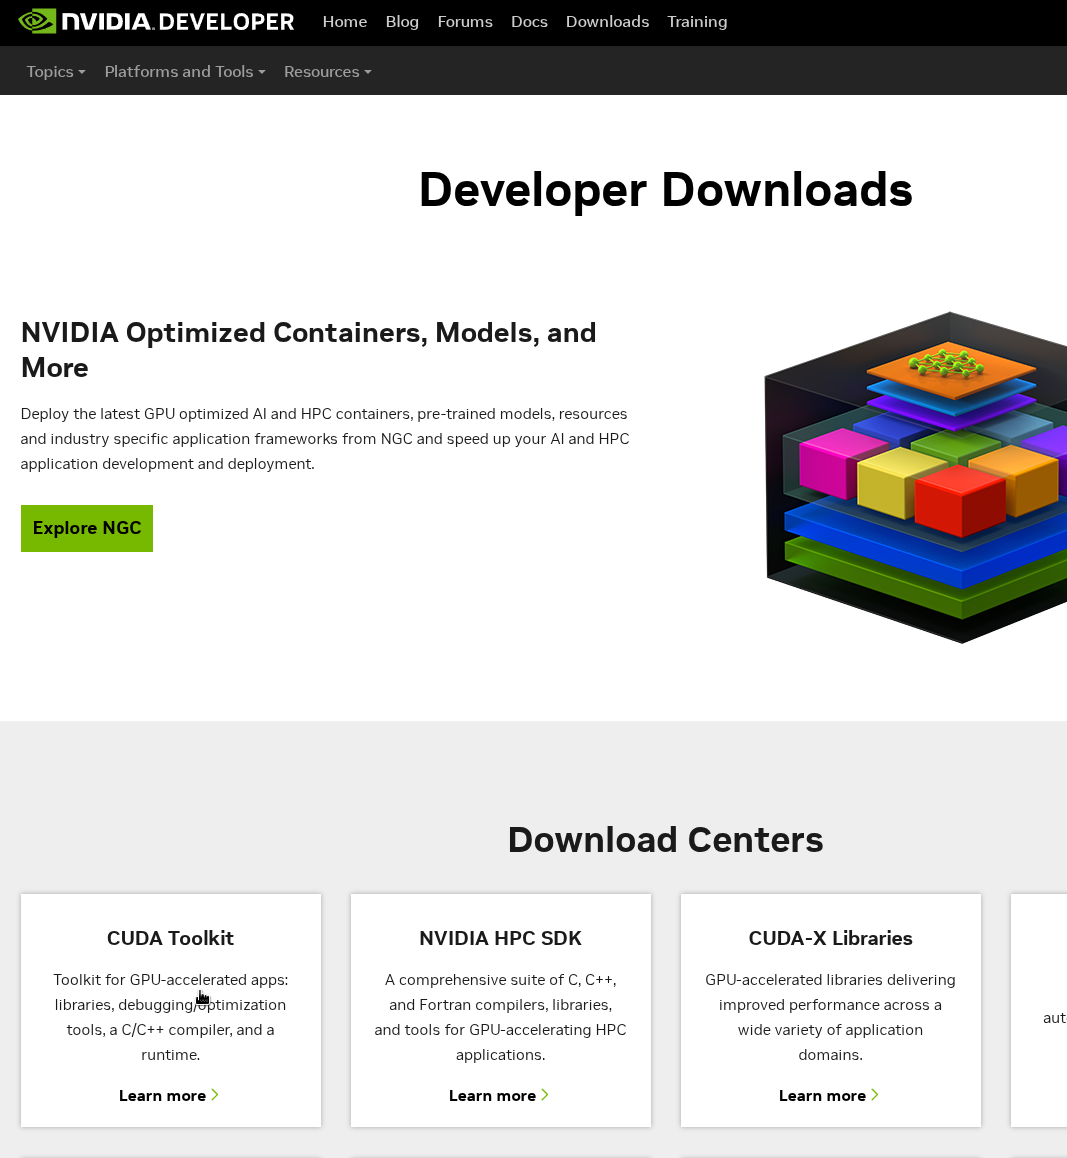
Находим CUDA Toolkit.
Нажимаем на Download Now.
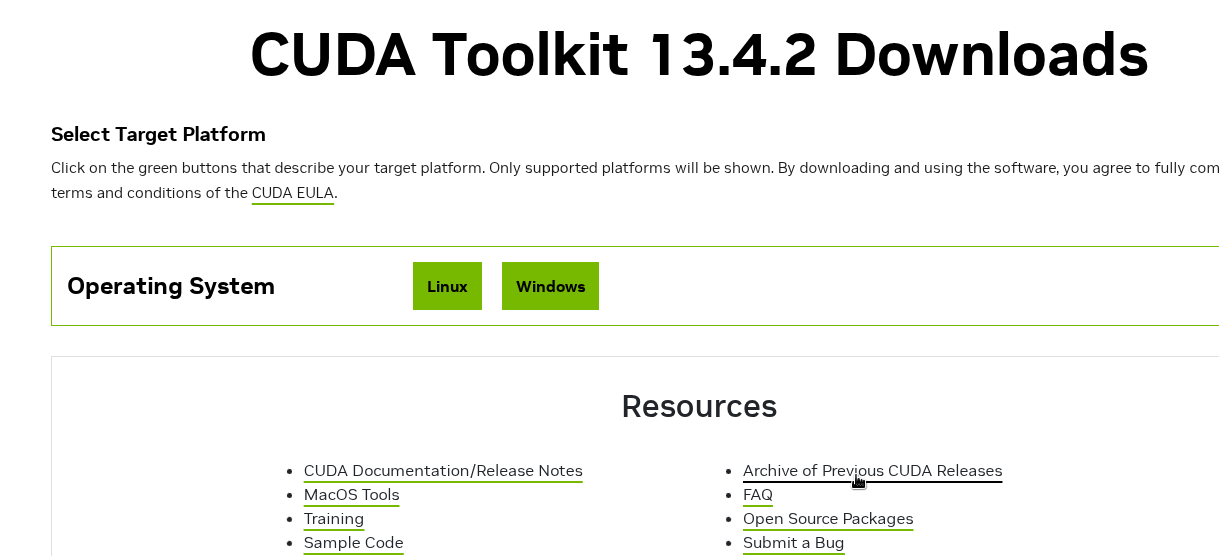
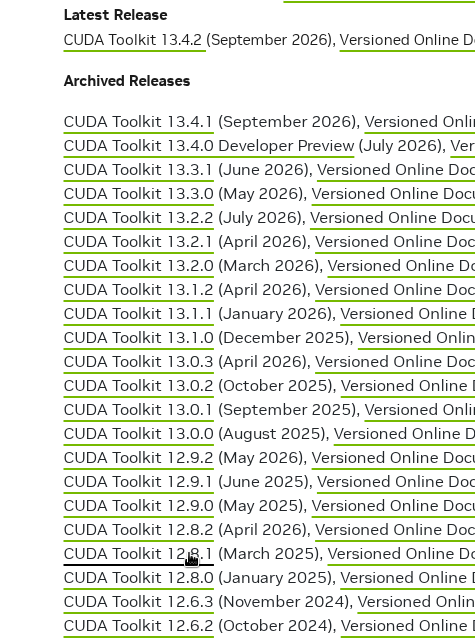
Попали на страницу загрузки, но меня интересует старая версия 12.8.1. Она вроде совместима с моим 12.4. Ищем кнопку Archive of Previous CUDA Releases. Находим в списке версию 12.8.1.
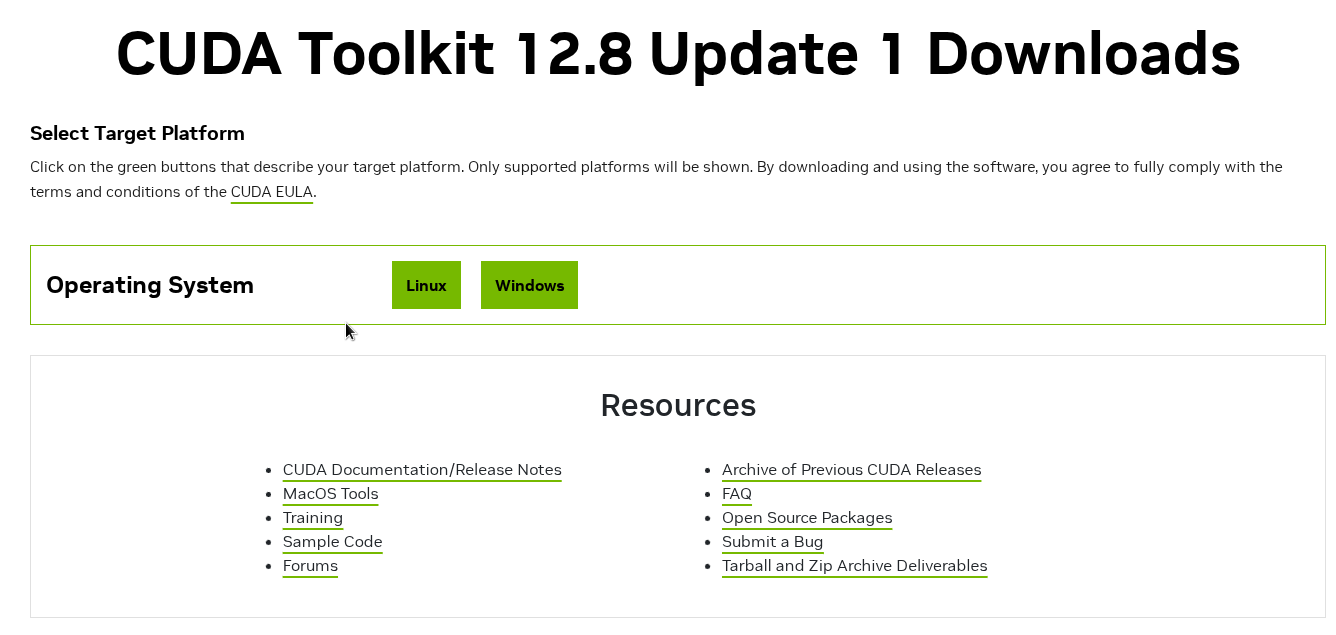
Далее выбираем версию. Так как Astra Linux на базе Debian, будем использовать для нее версию.
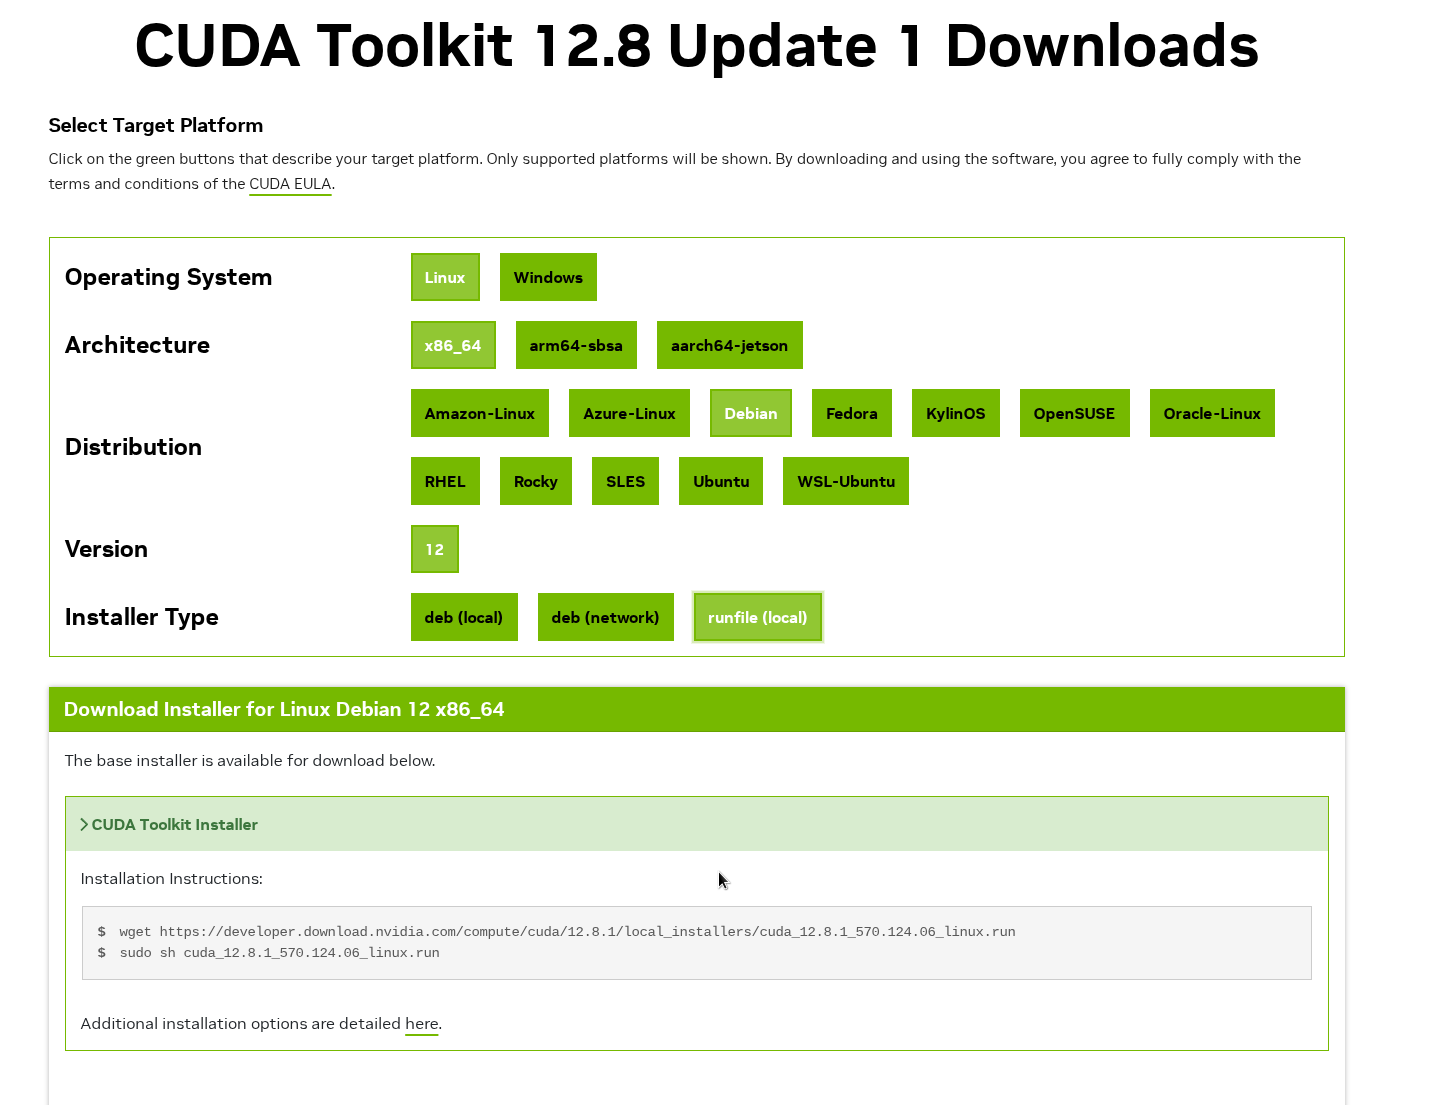
Сгенерировалась ссылка для загрузки. Переходим в загрузки:
cd ~/Загрузки
Загружаем бинарник установки.
P.s: объём бинарника → 5 ГБ!
wget https://developer.download.nvidia.com/compute/cuda/12.8.1/local_installers/cuda_12.8.1_570.124.06_linux.runЗапускаем установку:
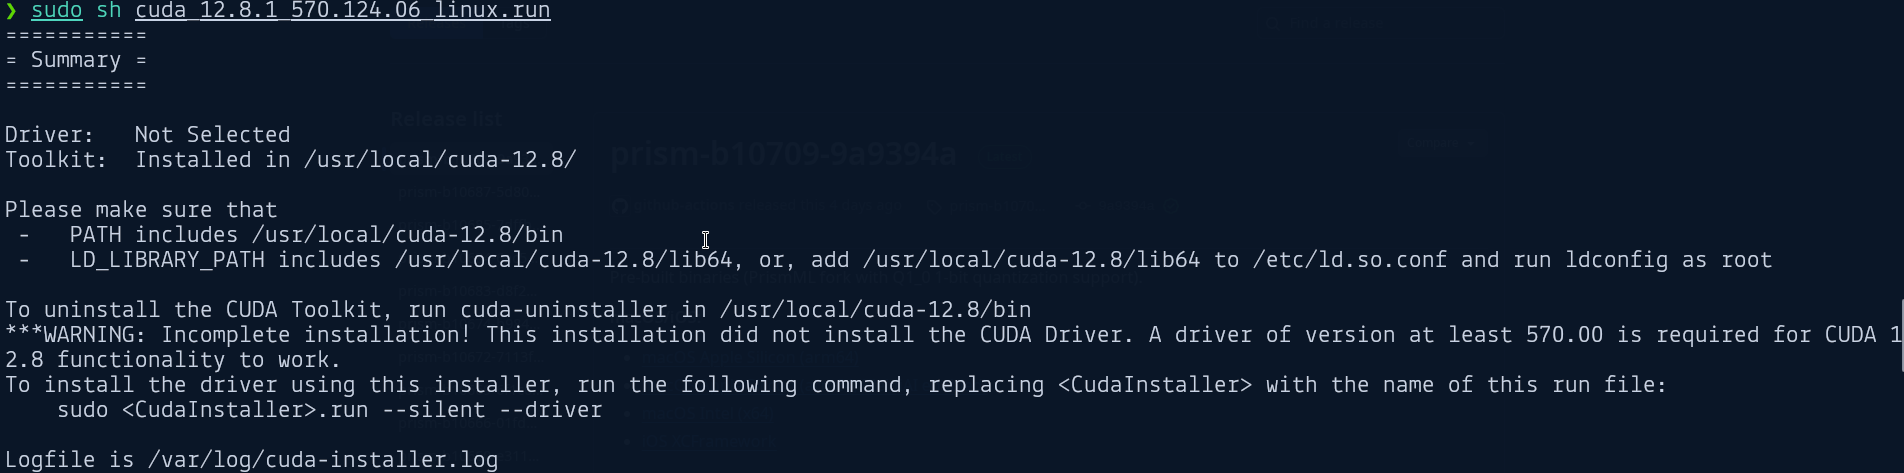
sudo sh cuda_12.8.1_570.124.06_linux.runВ открывшемся меню установщика:
- Снимаем галочку с Driver (драйвер у нас уже установлен);
- Убеждаемся, что стоит галочка на CUDA Toolkit 12.8;
- Нажимаем Install.
Шаг 5. Прописываем переменные окружения
После установки библиотеки будут находиться в /usr/local/cuda-12.8/lib64. Нужно добавить этот путь в переменную LD_LIBRARY_PATH. Так как я использую zsh, то добавляю в него, у вас скорее всего bash, то добавляйте в него (.bashrc):
echo 'export PATH=/usr/local/cuda-12.8/bin${PATH:+:${PATH}}' >> ~/.zshrc
echo 'export LD_LIBRARY_PATH=/usr/local/cuda-12.8/lib64${LD_LIBRARY_PATH:+:${LD_LIBRARY_PATH}}' >> ~/.zshrc
source ~/.zshrc
cd ~/bonsai-engine/llama-prism-b10709-9a9394a
Шаг 6. Снова проверяем видеокарту
Снова пытаемся запустить:
./llama-server --list-devices
На этот раз успех.

Хвала нейросетям)
Шаг 7. Запускаем модель
Но запуск все равно не удался.
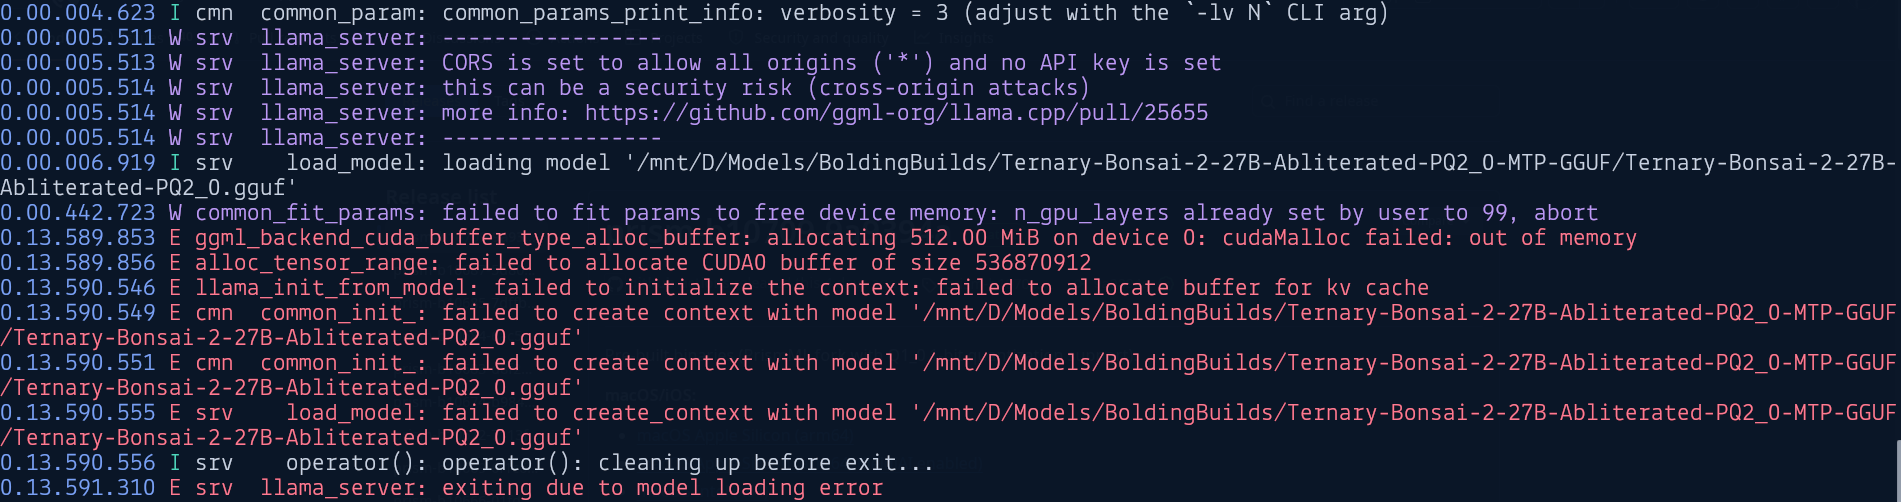
Ошибка cudaMalloc failed: out of memory означает, что для моей RTX 3070 (8 ГБ) просто не хватает видеопамяти для загрузки этой модели с текущими настройками. Модель Ternary-Bonsai-2-27B-Abliterated-PQ2_0.gguf весит около 7.2 ГБ, и даже без KV-кэша она занимает почти всю свободную память (у нас было доступно 6753 МБ, а модель требует больше).
Поигрался с количеством загрузки слоев в видюху -ngl, уменьшал с 99 до 50.
На -ngl 50 удалось запустить. Влезло 50 слоев в видюху, а остальное - в CPU. Также пришлось уменьшить контекст с 8192 до 4096.
UPD: внизу статьи, я дополнил информацией по запуску PQ1_0 в 1bit, которая полностью влезла в видеокарту и дала существенный буст по генерации ответов.
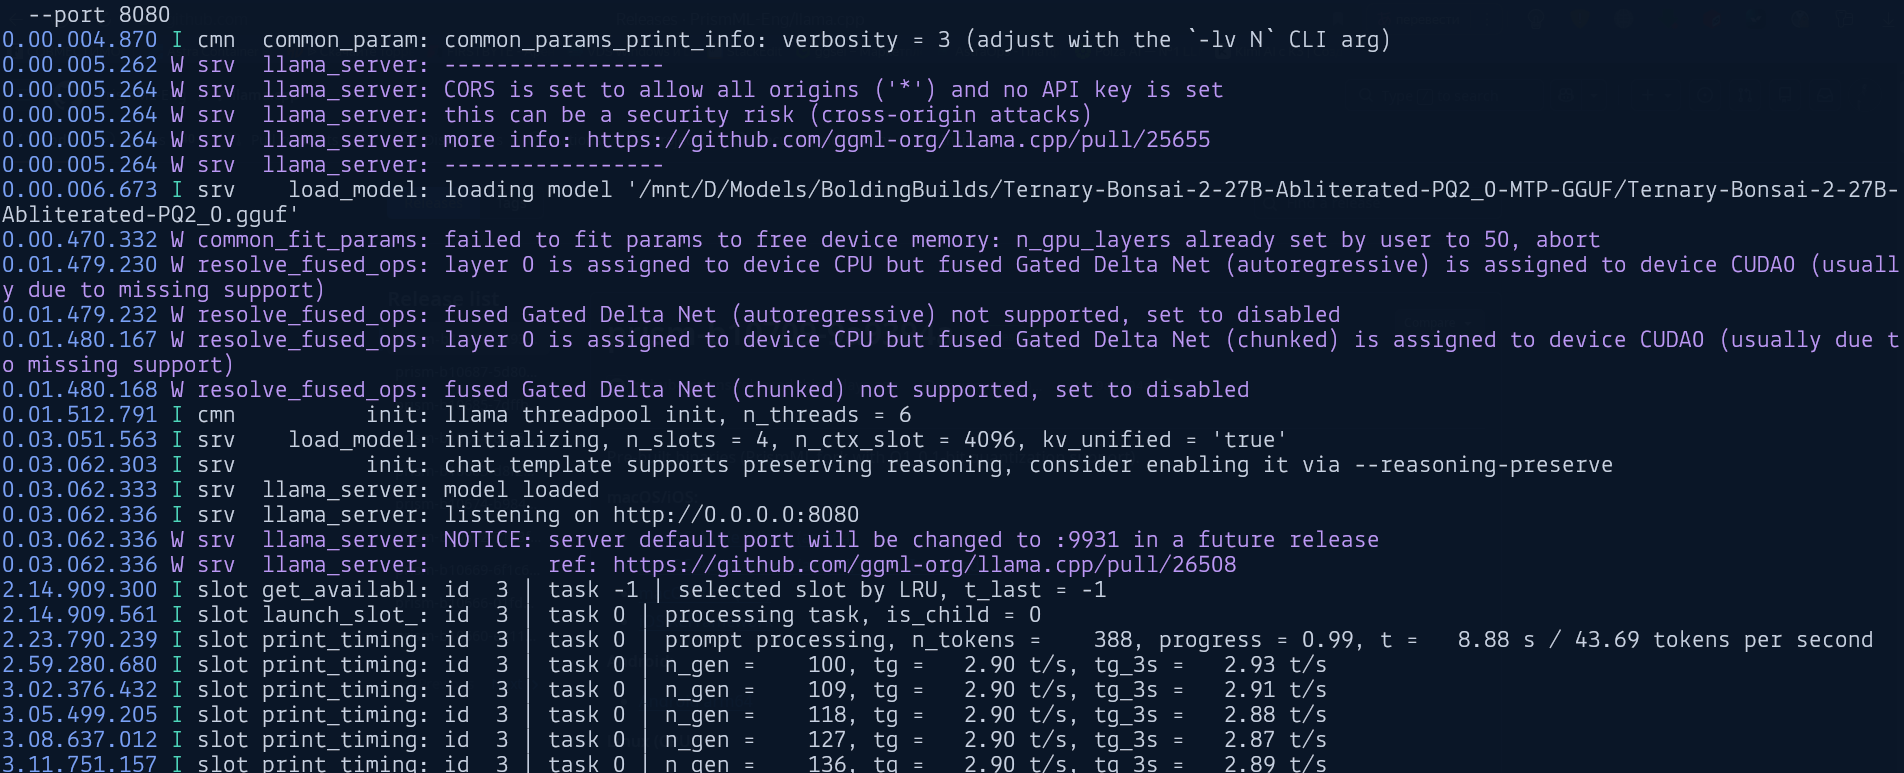
Итого команда запуска такая:
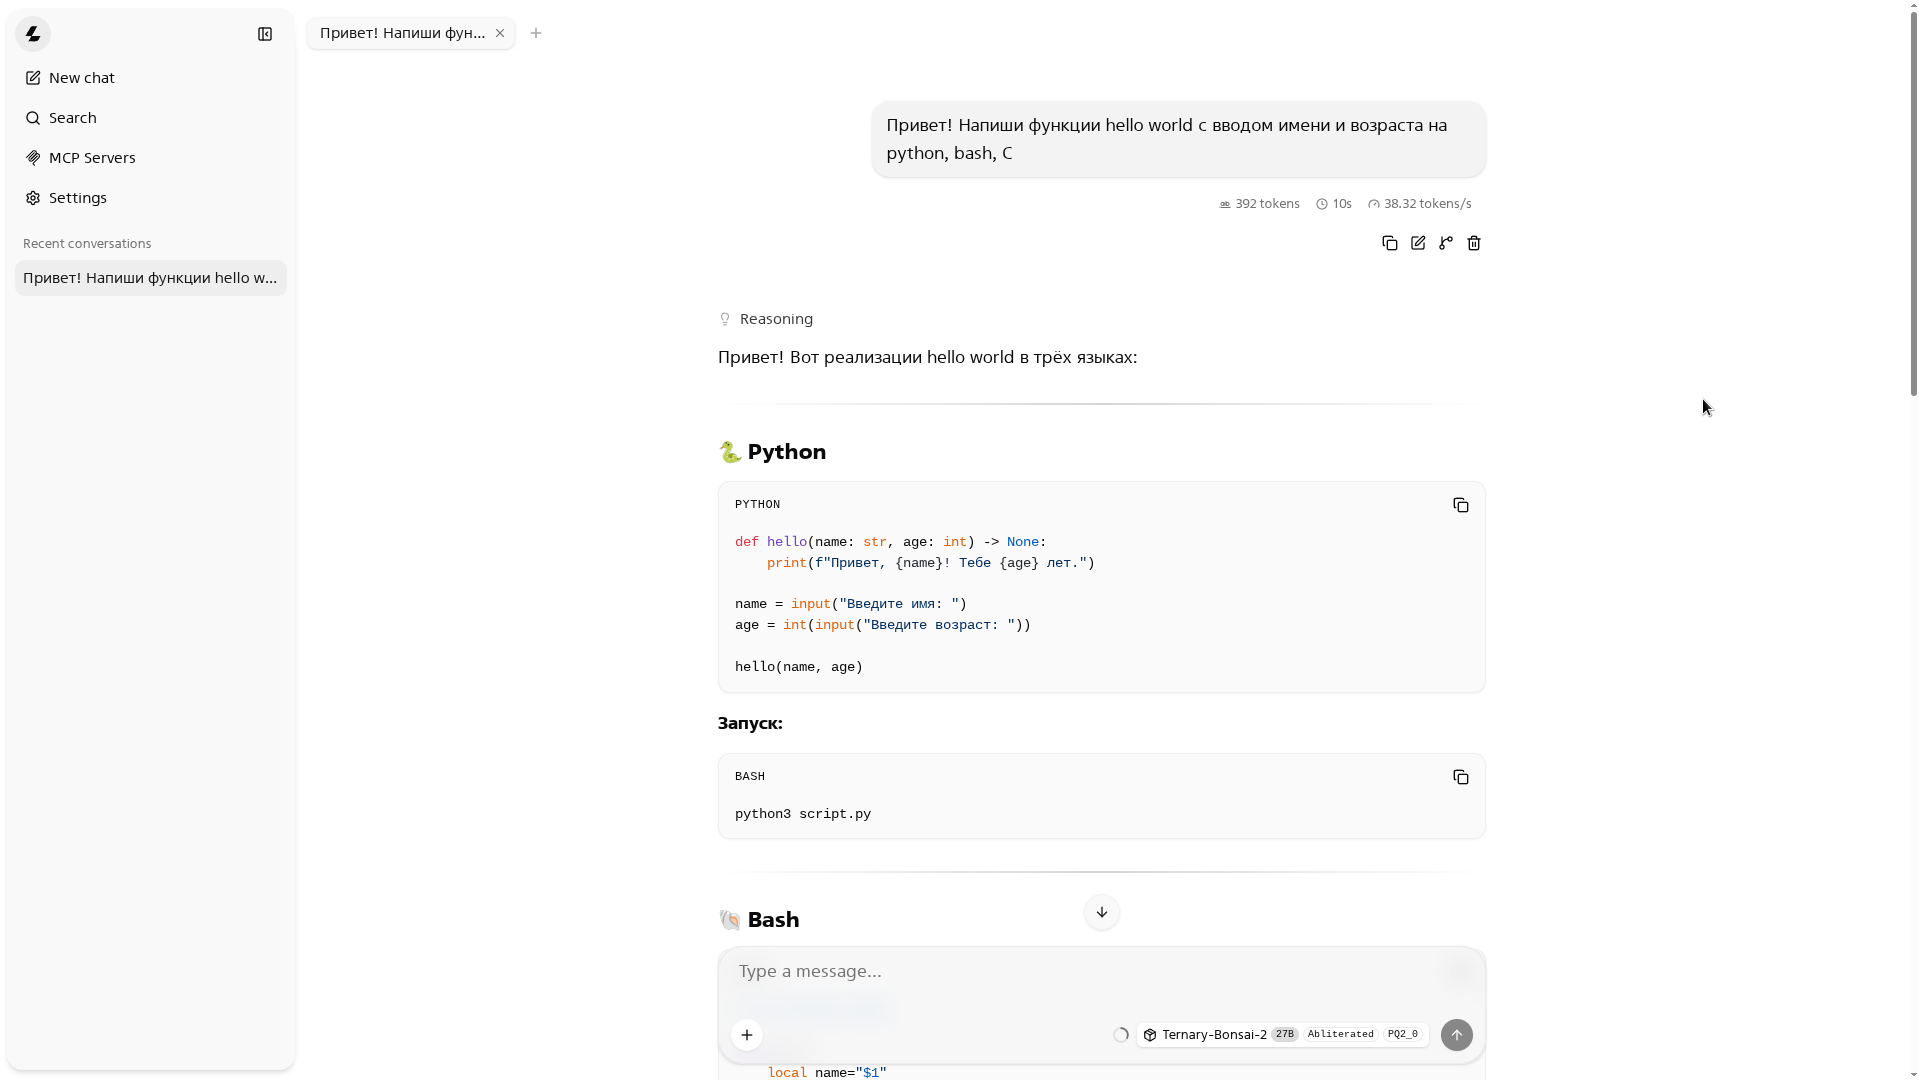
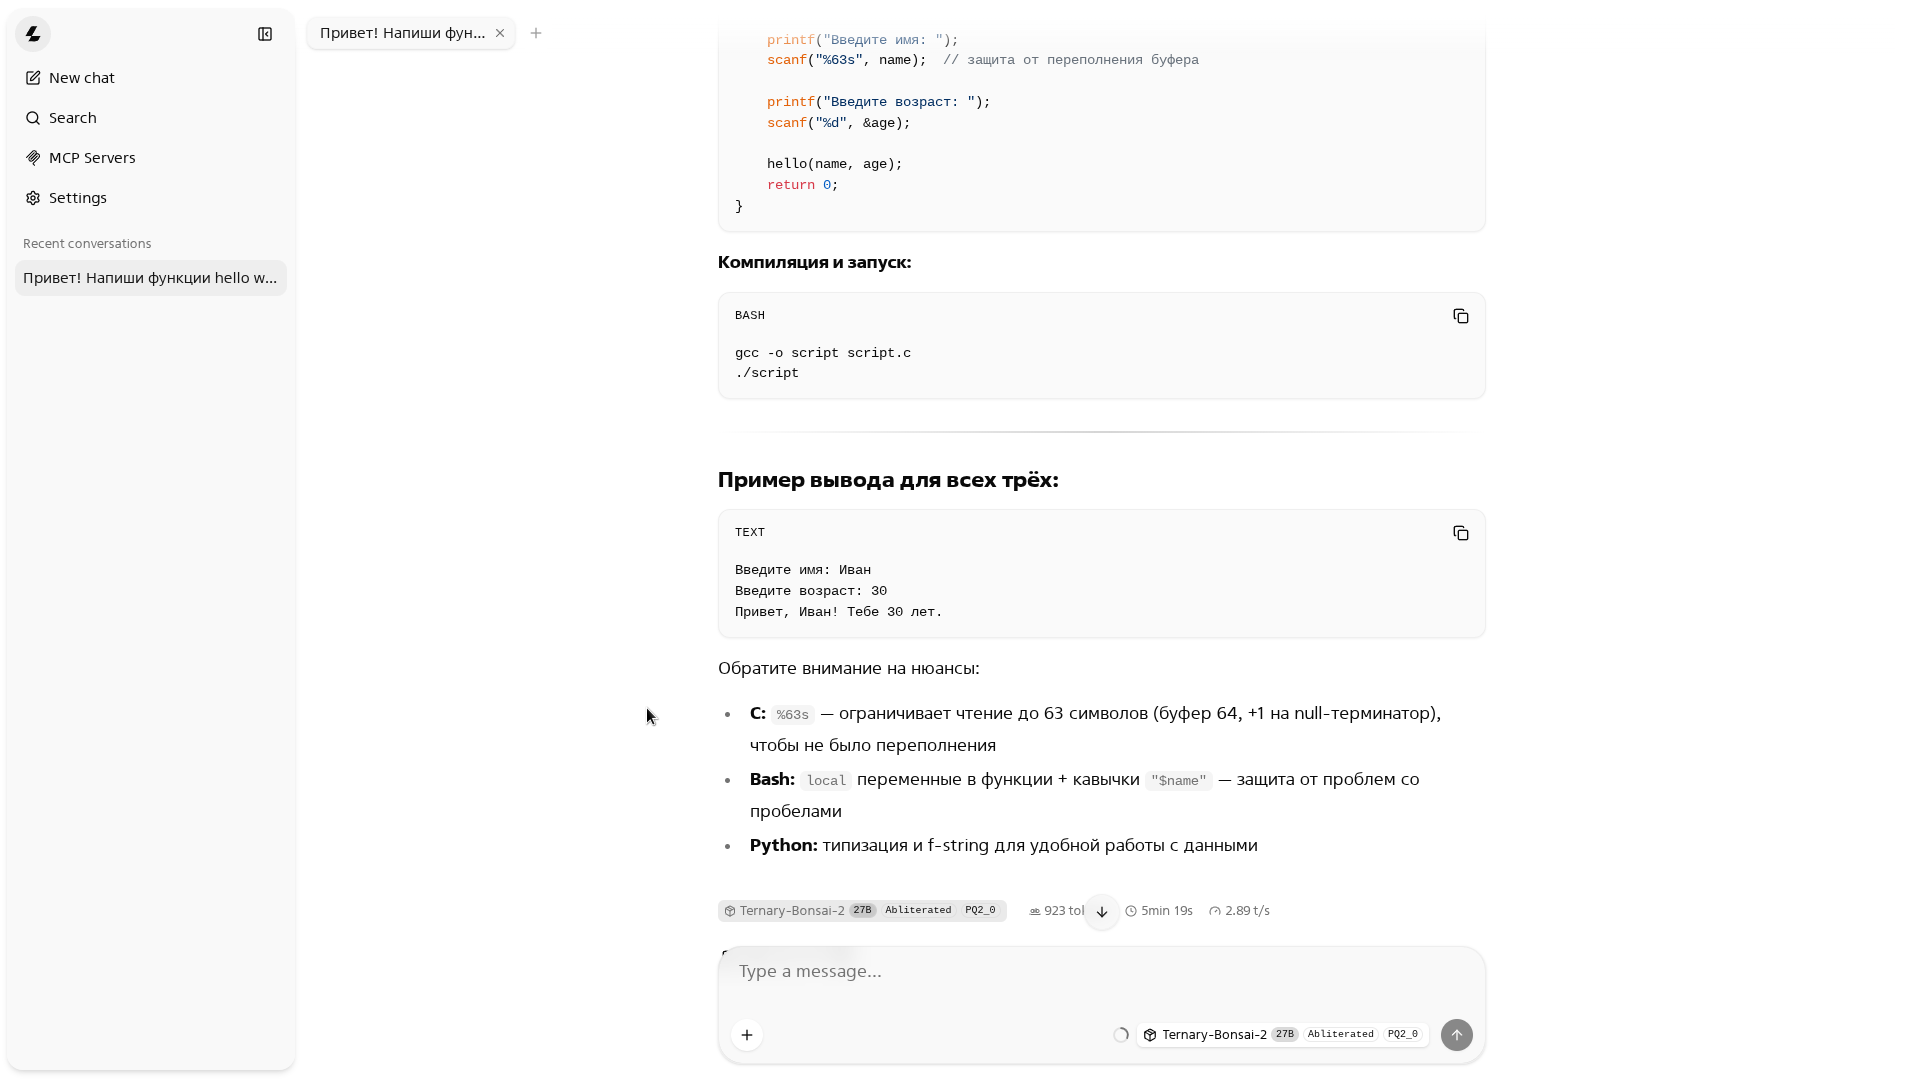
./llama-server -m /mnt/D/Models/BoldingBuilds/Ternary-Bonsai-2-27B-Abliterated-PQ2_0-MTP-GGUF/Ternary-Bonsai-2-27B-Abliterated-PQ2_0.gguf -ngl 50 -c 4096 --cache-type-k q4_0 --cache-type-v q4_0 --host 0.0.0.0 --port 8080Теперь в браузере по localhost:8080 мне удалось поиграться с данной моделью.
Итог
Из-за кастомного движка есть существенный минус. Именно поэтому нам и пришлось скачивать отдельную сборку от PrismML, чтобы запустить ее. Но, как вы уже видели, даже на моей RTX 3070 с 8 ГБ памяти она способна работать при правильной настройке слоев (-ngl) и контекста.
Несмотря на все сложности с запуском, результат того стоит: 27B-модель, умещающаяся в 5.9 ГБ и работающая на обычном ноутбуке обычном ПК - это действительно впечатляет. Если вам важна приватность и автономность, Ternary Bonsai 2 27B - отличный вариант для локального запуска. Если у Вас новый ноутбук с мощным железом, то да, можно считать, что на обычном ноутбуке это прекрасная альтернатива модели Qwen 3.8 на 27B.
UPDATE:
Я загрузил другую версию модели, более сжатой (Ternary-Bonsai-2-27B-PTQ1_0.gguf), она убирается полностью в мою видеокарту RTX 3070. Разница колосальная, если раньше ответ генерировался со скоростью ~3-4 токена в секунду, то теперь ~30 токенов в секунду. Загрузил я версию на 1bit.
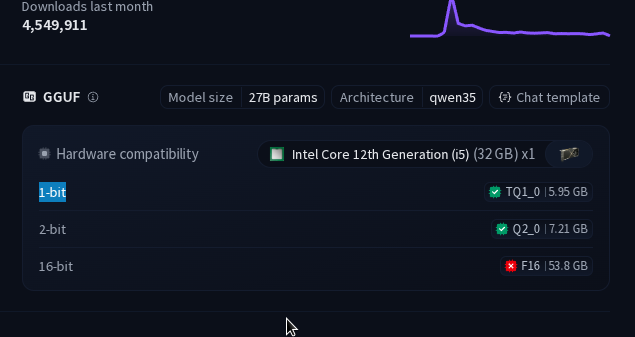
Снова изменил слои и команда для запуска получилась такой:
./llama-server -m /mnt/D/Models/prism-ml/Ternary-Bonsai-2-27B-gguf/Ternary-Bonsai-2-27B-PTQ1_0.gguf -ngl 99 -np 1 -c 16384 -fa on --cache-type-k q4_0 --cache-type-v q4_0 --agent --host 0.0.0.0 --port 8080
В данной команде увеличил контекст на 16к токенов, но моя видеокарта поддерживает 32к токенов максимально. Так же добавил ключ --agent, что позволяет нейросети управлять инструментами и взаимодействовать с моим компьютером. Но каждый раз писать такую строчку не удобно, по этому я попросил агента самому написать и настроить скрипт, который быстро бы запускал llama-server с тремя ключами на выбор контекста (8к токенов, 16к, 32к токенов). По умолчанию скрипт запустит в 32к токенов.
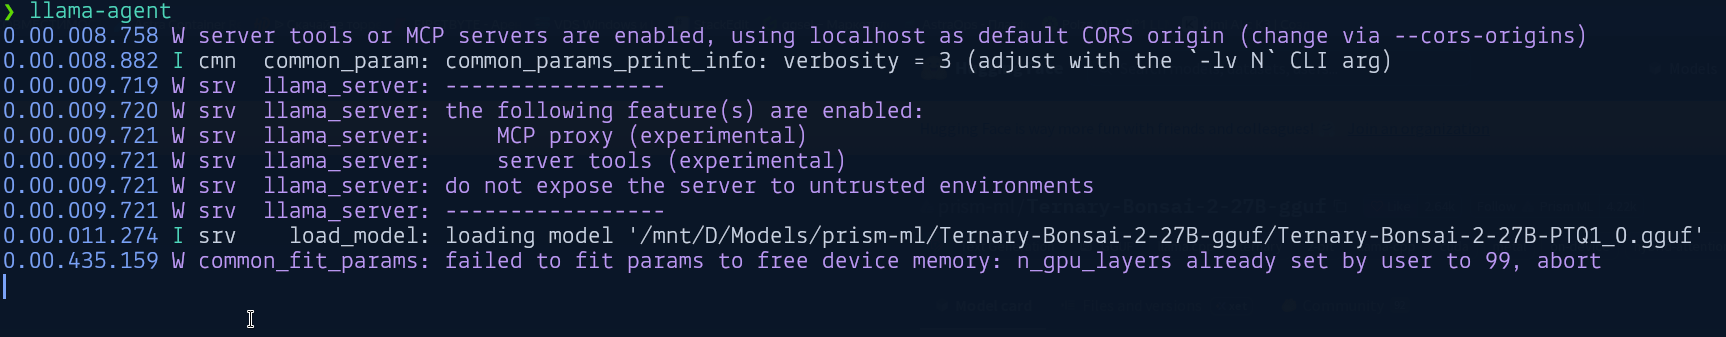
Агент написал скрипт llama-agent.sh, я его прикрепил внизу статьи, вы можете его загрузить и вам только поменять путь до расположения модели, закинуть скрипт в директорию, где у вас llama-server расположен и сделать симлинк скрипта в ~/.local/bin в домашней.
После загрузки скрипта, закиньте в директорию рядом с файлом llama-server, в этой же директории сделайте
chmod +x llama-agent.sh. Потом откройте скрипт любым редактором и измените путь к модели.
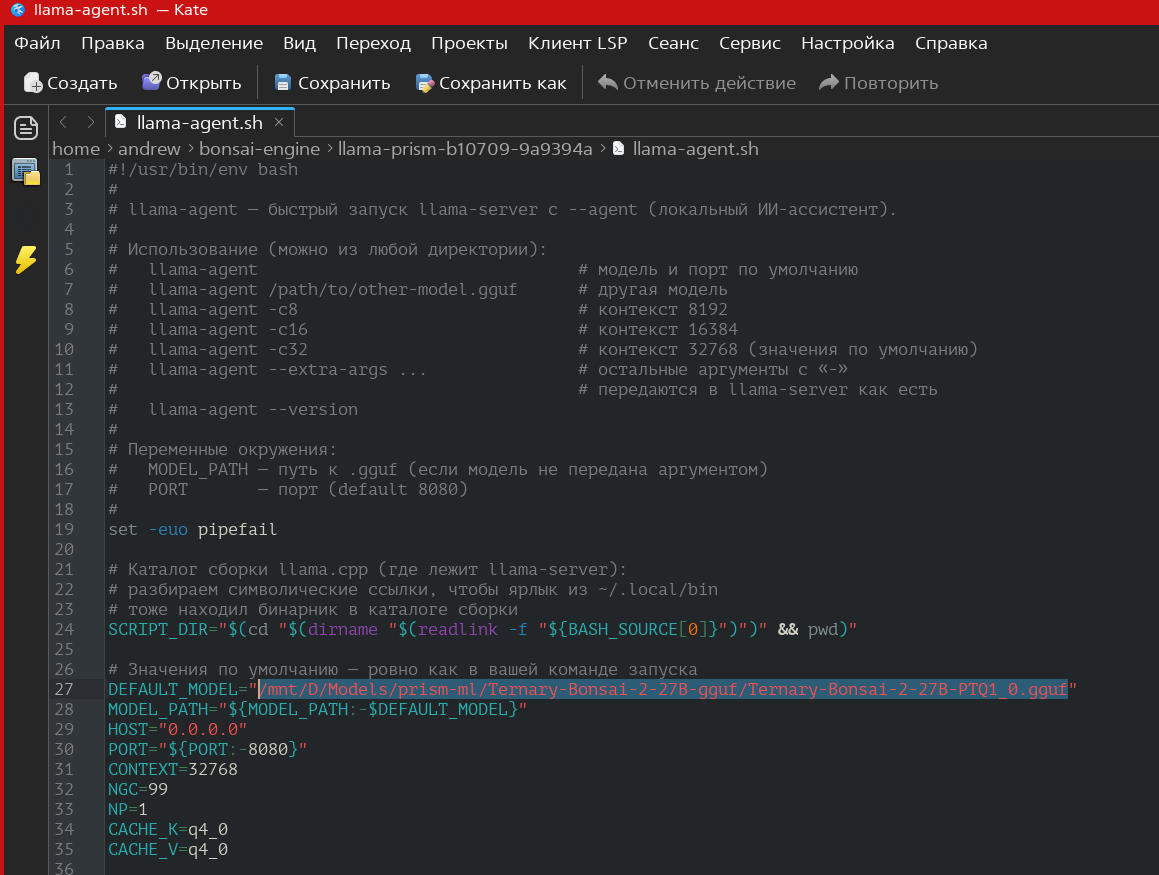
После этого сохраняйте и сделайте симлинк на быстрый запуск скрипта.
Вот пример для симлинка.
ln -s ~/bonsai-engine/llama-prism-b10709-9a9394a/llama-agent.sh ~/.local/bin/llama-agent
После этого перезапустите терминал и достаточно ввести llama-agent и скрипт сам запустит llama-server с нужными параметрами (по умолчанию с контекстом в 32к токенов, для запуска с 8к или 16к используйте ключи: llama-agent -c8 или llama-agent -c16, при желании можно изменить вручную настройки в скрипте CONTEXT=).